- Czy sztuczna inteligencja zrewolucjonizuje odkrywanie leków?
- AI reality check
- Dane – najmniej widowiskowy, ale fundamentalny element AI
- Dlaczego modele AI lepiej sprawdzają się w Fazie I, niż Fazie II?
- Największym wyzwaniem nie jest technologia
- Co może zmienić przyszłość?
- Podsumowanie
- Źródło inspiracji
August 3, 2026 • Jan Klaszczyk • 5 min reading time
Specjaliści w bigpharma: fundamenty danych ważniejsze niż modele AI
Czy sztuczna inteligencja zrewolucjonizuje odkrywanie leków?
Patrząc na medialne nagłówki, można odnieść wrażenie, że jesteśmy o krok od momentu, w którym AI samodzielnie zaprojektuje nowy lek, przeprowadzi badania kliniczne i rozwiąże największe problemy współczesnej medycyny.
Rzeczywistość wygląda jednak zupełnie inaczej.
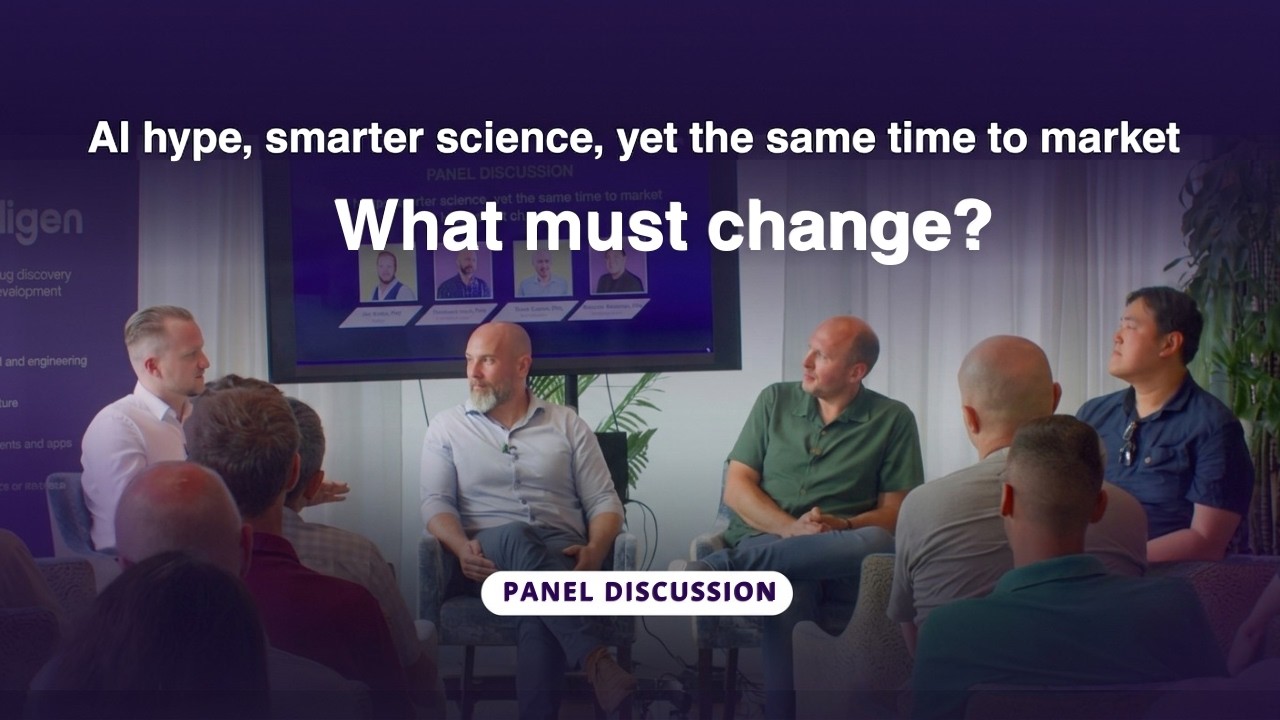
Podczas panelu ekspertów z Merck, Genomics England oraz Jazz Pharmaceuticals, który odbył się 6 lipca 2026 roku w Cambridge, wybrzmiał bardzo spójny przekaz: największym ograniczeniem AI nie są modele - są nim dane oraz sposób, w jaki organizacje potrafią z nich korzystać.
AI reality check
Od kilku lat obserwujemy ogromny entuzjazm wokół generatywnej sztucznej inteligencji. Wiele osób oczekuje, że wystarczy dostarczyć modelowi odpowiednią ilość danych, a ten zaprojektuje przełomowy lek.
Eksperci zgodnie podkreślali, że taki scenariusz jest dziś bardziej marketingową wizją niż rzeczywistością.
Największą wartość AI przynosi obecnie w zadaniach, które trudno nazwać spektakularnymi takich jak:
- automatyczne przeglądanie dokumentacji regulacyjnej,
- wykrywanie anomalii w ogromnych zbiorach danych,
- analizę tysięcy publikacji naukowych,
- tworzenie i tłumaczenie dokumentacji wymaganej przez organy regulacyjne.
To właśnie tam firmy farmaceutyczne już dziś osiągają realne korzyści.
Jak zauważył Bolek Zapiec, kierujący obszarem Digital & Data Science w Merck, właśnie sprawy regulacyjne należą do najbardziej kosztownych elementów procesu R&D, a generatywna AI już teraz znacząco przyspiesza przygotowywanie dokumentacji w wielu językach.
To nie brzmi tak efektownie jak “AI odkrywające nowe leki”, ale właśnie takie zastosowania przynoszą dziś największy zwrot z inwestycji.
Dane – najmniej widowiskowy, ale fundamentalny element AI
Istotę rzeczy dobrze określa metafora, która padła od Adrianto Wirawana z Genomics England.
Każdy chce gotować, ale ktoś musi wcześniej pozmywać naczynia.
Inaczej mówiąc: wszyscy chcą budować modele AI, ale niewielu chce zajmować się przygotowaniem danych.
Tymczasem wciąż obowiązuje stara zasada nauk o danych:
Garbage in, garbage out.
Model nigdy nie będzie lepszy od danych, na których został wytrenowany.
Dlatego coraz częściej mówi się nie o tym, ile danych posiada organizacja, ale ile z nich jest rzeczywiście AI-ready – odpowiednio opisanych, ustandaryzowanych i gotowych do wykorzystania przez modele.
Co ciekawe, zgodnie z tym co zdradził Bolek Zapiec, w Merck dane starsze niż 10–15 lat bardzo rzadko trafiają do procesów trenowania modeli. Powód jest prosty - historyczne dane często były zbierane według zupełnie innych standardów jakości niż obecnie.
Tak więc, petabajty* danych nie mają większego znaczenia, jeśli nie można im zaufać.
*Petabajt = 1 000 000 GB
Dlaczego modele AI lepiej sprawdzają się w Fazie I, niż Fazie II?
Jednym z ciekawszych wątków panelu było przywołanie wyników projektowania leków z wykorzystaniem AI w różnych fazach badań klinicznych. Okazuje się, że cząsteczki będące kandydatami na lek badany, które zostały opracowane przy wsparciu sztucznej inteligencji osiągają bardzo dobre rezultaty w I fazie badań klinicznych, gdzie głównym celem jest ocena bezpieczeństwa. W niektórych analizach wskaźniki sukcesu sięgają nawet 80–90%. Problem pojawia się jednak w II fazie, gdzie oceniana jest skuteczność terapeutyczna. Tutaj AI nie osiąga wyników wyraźnie lepszych od tradycyjnych metod odkrywania leków. Eksperci wskazali dwa główne powody
- Po pierwsze, modele uczą się na podstawie wcześniejszych doświadczeń. Oznacza to, że bardzo dobrze rozpoznają wzorce, które już znamy, ale znacznie trudniej jest im zaproponować rozwiązania całkowicie przełomowe.
- Po drugie, większość modeli nie ma dostępu do wysokiej jakości danych klinicznych. Znaczna część wiedzy pochodzi z eksperymentów laboratoryjnych wykonywanych na komórkach lub modelach zwierzęcych, podczas gdy rzeczywiste wyniki badań klinicznych często pozostają niepubliczne.
To sprawia, że modele AI dość dobrze przewidują zachowanie cząsteczek w laboratorium, ale znacznie gorzej radzi sobie z przewidywaniem ich działania u pacjentów.
Największym wyzwaniem nie jest technologia
Paradoksalnie, największą przeszkodą we wdrażaniu AI nie są algorytmy.
Jest nią człowiek.
Według uczestników panelu wykorzystanie narzędzi typu AI Copilot w organizacjach farmaceutycznych, przez pracowników, którzy na co dzień nie zajmują się danymi, nadal jest znikomy.
Powód?
Pracownicy umysłowi nie obawiają się, że AI przejmie najbardziej monotonne obowiązki. Wręcz przeciwnie – wielu z nich chętnie oddałoby żmudne przygotowywanie dokumentacji czy analizę ogromnych zbiorów danych.
Prawdziwy niepokój budzi możliwość automatyzacji tej najbardziej kreatywnej części pracy: projektowania eksperymentów, formułowania hipotez i podejmowania decyzji naukowych.
To właśnie kultura organizacyjna i budowanie zaufania do modeli stają się dziś równie ważne jak rozwój samej technologii.
Tutaj za przykład znów może posłużyć polityka wdrożona w Merck a mianowicie “Prediction First”. Wprowadzona w Merck zasada mówi, że zanim chemik rozpocznie syntezę nowego związku, musi najpierw skonfrontować swój pomysł z predykcją modelu AI. Nie oznacza to obowiązku podporządkowania się modelowi bo decyzja końcowa nadal należy do naukowca. AI staje się jednak obowiązkowym partnerem w procesie podejmowania decyzji.
Co może zmienić przyszłość?
Eksperci wskazali kilka kierunków, które mogą w najbliższych latach znacząco zwiększyć wpływ AI na rozwój nowych terapii.
Jednym z najbardziej obiecujących są cyfrowe bliźniaki zwierząt laboratoryjnych. Dzięki wykorzystaniu ogromnych historycznych zbiorów danych możliwe może być tworzenie wirtualnych grup kontrolnych, co ograniczyłoby liczbę zwierząt wykorzystywanych w badaniach i znacznie przyspieszyłoby badania przedkliniczne kandydatów na lek.
Drugim wskazanym kierunkiem jest integracja elektronicznej dokumentacji medycznej pacjentów z danymi omicznymi*. Takie podejście pozwoli znacznie precyzyjniej dobierać pacjentów do badań klinicznych i rozwijać medycynę spersonalizowaną.
Najbardziej ambitną wizją pozostaje jednak tworzenie modeli, które nie będą jedynie wyszukiwać korelacji, ale zaczną rozumieć zależności przyczynowo-skutkowe zachodzące w biologii. To właśnie taki poziom rozumienia procesów biologicznych może stać się kolejnym przełomem w wykorzystaniu AI w farmacji.
*dane omiczne - wielkoskalowe informacje biologiczne dotyczące całościowych zbiorów cząsteczek w organizmie, takich jak genomika (DNA), proteomika (białka) oraz metabolomika (metabolity)
Podsumowanie
Choć medialny szum wokół sztucznej inteligencji często sugeruje, że największe znaczenie mają coraz większe modele językowe, praktyka pokazuje coś zupełnie innego.
W farmacji wygrywają nie organizacje posiadające najbardziej efektowne modele, lecz te, które dysponują najwyższej jakości danymi, potrafią je właściwie uporządkować oraz budują kulturę współpracy między naukowcami a AI.
To właśnie solidne fundamenty danych, a nie spektakularne demonstracje możliwości modeli AI będą decydować o tym, kto w najbliższych latach rzeczywiście pozostanie konkurencyjny w branży farmaceutycznej.
Właśnie takie podejście do danych przyświeca nam w Data4Lifesciences. Chcemy pomóc wpierw “poukładać” procesy, dane i architekturę informatyczną aby w dalszej kolejności pracować na uporządkowanych informacjach, które mogą posłużyć do ich analizy i wdrożeń modeli AI w organizacji
Źródło inspiracji
Artykuł powstał na podstawie panelu dyskusyjnego “AI in Drug Discovery: Hype vs Reality”, który odbył się 6 lipca 2026 roku w Cambridge (Wielka Brytania). W dyskusji uczestniczyli Adrianto Wirawan, PhD (Director of Bioinformatics Engineering, Genomics England), Bolek Zapiec, PhD (Head of Digital & Data Science, Discovery Development Technologies, Merck) oraz Emanuele Loro, PhD (Associate Director of Bioinformatics, Jazz Pharmaceuticals). Panel poprowadził Jan Majta, PhD, Director of AI Solutions w Ardigen.
Źródło: